


Immaginate di assumere un nuovo dipendente molto capace. Gli spiegate cosa deve fare, gli date accesso ai sistemi aziendali e poi… ve ne andate in vacanza per un mese. Al vostro ritorno, scoprite che ha preso centinaia di decisioni autonome, ha modificato documenti importanti, ha inviato e-mail a clienti e fornitori, e ha persino assunto altri collaboratori. Alcune scelte erano ottime. Altre erano basate su informazioni sbagliate che lui stesso aveva ricevuto da altri colleghi altrettanto autonomi.
Questa è, in estrema sintesi, la situazione in cui ci troviamo oggi con i sistemi di Intelligenza Artificiale Agentiva (definiti anche come Agentic AI). Non si tratta più di semplici programmi che rispondono a domande: stiamo parlando di sistemi capaci di agire nel mondo reale, prendere decisioni, collaborare con altri sistemi AI e farlo senza che un essere umano li supervisioni passo dopo passo.
Definizioni
Vediamo di seguito alcune definizioni relative ai temi trattati.
Agente AI
Partiamo dall’inizio, ossia dalla definizione.
Un Agente AI è un programma di intelligenza artificiale che è capace di compiere azioni nel mondo digitale (e talvolta fisico) per raggiungere un obiettivo. La parola chiave è “azione”.
Pensate alla differenza tra un dizionario e un assistente personale. Il dizionario vi dà la definizione di una parola quando gliela chiedete. L’assistente personale, invece, può prenotare un ristorante per voi, mandare un messaggio al vostro capo per dirgli che arriverete tardi, e nel frattempo aggiornare il vostro calendario, tutto da solo, senza che voi dobbiate fare nulla tranne dire “prenota un tavolo per stasera”.
Un agente AI funziona in modo simile. Può navigare su Internet, compilare moduli, inviare e-mail, leggere e scrivere documenti, interagire con altri programmi, e molto altro ancora. La distinzione fondamentale rispetto ai normali programmi di AI (come ad esempio i chatbot, ossia ChatGPT) è questa capacità di “fare” le cose, non solo di “dirle”.
Un esempio pratico è quello di Marco, un piccolo imprenditore, usa un agente AI per gestire i preventivi. L’agente legge le richieste dei clienti arrivate per e-mail, calcola i costi consultando il listino prezzi aggiornato, redige il preventivo in formato PDF e lo invia al cliente. Marco deve solo controllare i risultati a fine giornata.
Il sistema di Agentic AI
Se un singolo agente AI è come un assistente personale capace e autonomo, un sistema di Agentic AI è come un’intera azienda di assistenti che lavorano tutti insieme, si coordinano, si passano informazioni e si dividono i compiti.
Un sistema Agentic AI non è un singolo programma, ma una struttura organizzata in cui più agenti AI collaborano per raggiungere obiettivi complessi. Ogni agente può specializzarsi in un compito diverso, per esempio uno analizza i dati, uno comunica con il cliente, uno gestisce i pagamenti, uno coordina gli altri.
Questi sistemi possono includere sia agenti che operano localmente (nel vostro computer o nei server della vostra azienda) sia agenti remoti, che si trovano fisicamente altrove ma che sono raggiungibili attraverso internet. Ed è qui che entra in gioco un concetto tecnico importante, che però ha implicazioni molto pratiche.
Il protocollo MCP ossia il linguaggio comune degli agenti
MCP è l’acronimo di Model Context Protocol. MCP è il linguaggio standardizzato che permette agli agenti AI di comunicare tra loro e di accedere a servizi e strumenti esterni.
Pensate a come funziona una presa elettrica. In Italia, tutte le spine hanno la stessa forma e possono essere inserite in qualsiasi presa. Non importa chi ha prodotto l’elettrodomestico: se rispetta lo standard, funziona. MCP fa la stessa cosa per gli agenti AI: definisce un modo standard con cui un agente AI può “collegarsi” a strumenti, servizi e altri agenti.
Questo è al tempo stesso una grande comodità e un potenziale rischio.
La comodità è che un agente AI può facilmente accedere a e-mail, calendari, database aziendali, servizi web e altri agenti senza che ogni connessione debba essere programmata da zero, ma il rischio è che se un agente è compromesso o lavora con informazioni sbagliate, può propagare gli effetti a tutto ciò cui è connesso attraverso MCP.
Analogamente in un sistema idraulico, MCP è la rete di tubi. Se l’acqua è pulita, arriva pulita ovunque. Se entra del veleno da un punto della rete, può contaminarla tutta.
Il coinvolgimento umano nel Processo
Qui arriviamo a un concetto fondamentale per capire i rischi: il livello di supervisione umana sui sistemi AI. Gli esperti usano diverse sigle per indicare quanto un essere umano sia coinvolto nelle decisioni prese dall’intelligenza artificiale. Vediamole in ordine, dalla supervisione massima a quella minima.
HITL — Human In The Loop (L’umano nel ciclo)
In questo scenario, per ogni decisione importante l’AI si ferma e aspetta l’approvazione di un essere umano. È come avere un assistente che, prima di spedire qualsiasi lettera, ve la porta da firmare. Lento, ma sicuro.
HOTL — Human On The Loop (L’umano al disopra del ciclo)
Qui l’AI agisce autonomamente, ma un supervisore umano monitora in tempo reale ciò che fa e può intervenire se qualcosa va storto. È come avere un assistente che lavora, mentre voi guardate uno schermo che mostra tutto ciò che fa, con un pulsante rosso di emergenza a portata di mano.
HOOTL — Human Out Of The Loop (L’umano fuori dal ciclo)
In questo caso l’AI opera completamente in autonomia. Nessun umano supervisiona in tempo reale. Le decisioni vengono prese, le azioni vengono compiute, e l’essere umano — se mai lo fa — controlla i risultati solo dopo, a posteriori. È come assumere un direttore generale e poi andarsene in pensione, sperando che tutto vada bene.
È importante capire che non esiste una modalità “giusta” in assoluto, ma dipende dal contesto. Un agente AI che ordina automaticamente le forniture di carta per l’ufficio può tranquillamente operare in HOOTL. Un agente AI che decide se concedere un mutuo a una famiglia o se autorizzare un intervento chirurgico dovrebbe invece operare in HITL.
Il problema, come vedremo, è che questa distinzione non sempre viene fatta con la dovuta attenzione.
I rischi dei sistemi di agenti AI
Vediamo ora quali sono i rischi che possono essere connessi all’utilizzo degli Agenti AI.
Bias
Il bias — in italiano si potrebbe tradurre come “pregiudizio” o “distorsione” — è uno dei rischi più insidiosi dell’intelligenza artificiale. Un sistema AI impara dai dati con cui è stato addestrato, ma se quei dati contengono pregiudizi, errori o rappresentazioni distorte della realtà, l’AI li assorbe e li riproduce, talvolta amplificandoli.
Facciamo un esempio concreto. Supponiamo che un’azienda voglia usare un agente AI per selezionare i curriculum vitae. Se i dati storici di assunzione dell’azienda mostrano che negli ultimi vent’anni sono stati assunti soprattutto uomini di età compresa tra i 25 e i 40 anni, l’AI potrebbe “imparare” che queste caratteristiche correlano con il successo lavorativo e iniziare a scartare automaticamente le candidate donne o i candidati over 50. Non perché l’AI sia “cattiva”: semplicemente perché ha imparato dai dati storici, che riflettevano una discriminazione preesistente.
Il bias non è sempre così evidente. Può manifestarsi in forme molto sottili: nella scelta delle parole usate per descrivere un prodotto, nelle raccomandazioni di acquisto, nelle notizie mostrate per prime, nel modo in cui vengono calcolati i rischi finanziari. E quando un agente AI con bias opera in autonomia, le sue decisioni distorte si moltiplicano senza che nessuno le noti.
Vediamo un esempio pratico. Sofia usa un’app di AI per ricevere consigli di investimento. L’AI, addestrata su dati storici di un periodo in cui i tassi erano molto diversi, continua a consigliare obbligazioni a lungo termine anche quando il mercato è cambiato. Sofia perde denaro, ma non sa perché: l’AI le ha dato un consiglio con estrema sicurezza.
Ma il bias è solo uno dei problemi. I sistemi di Agenti AI presentano un ventaglio più ampio di rischi che vale la pena conoscere.
Le allucinazioni
I modelli di AI generativa tendono a produrre, con grande sicurezza, informazioni che sono completamente false. Gli esperti chiamano questo fenomeno “allucinazione”. Un agente AI può inventare fatti, citare fonti inesistenti, fornire dati sbagliati ma può farlo con un tono assolutamente autorevole. Quando questo avviene in un sistema autonomo, l’agente può agire su informazioni false, prendere decisioni sbagliate e diffondere la disinformazione ad altri sistemi.
Deriva dell’Obiettivo
Un agente AI è programmato per raggiungere un obiettivo. Ma il modo in cui persegue quell’obiettivo può, nel tempo, allontanarsi da ciò che era stato inteso originariamente. È come dare a qualcuno il compito di “risparmiare i costi aziendali” senza altre istruzioni: potrebbe iniziare a tagliare spese sensate, poi passare a non pagare i fornitori, poi a licenziare personale essenziale. Formalmente sta perseguendo l’obiettivo, ma non nel modo voluto.
Attacchi Esterni
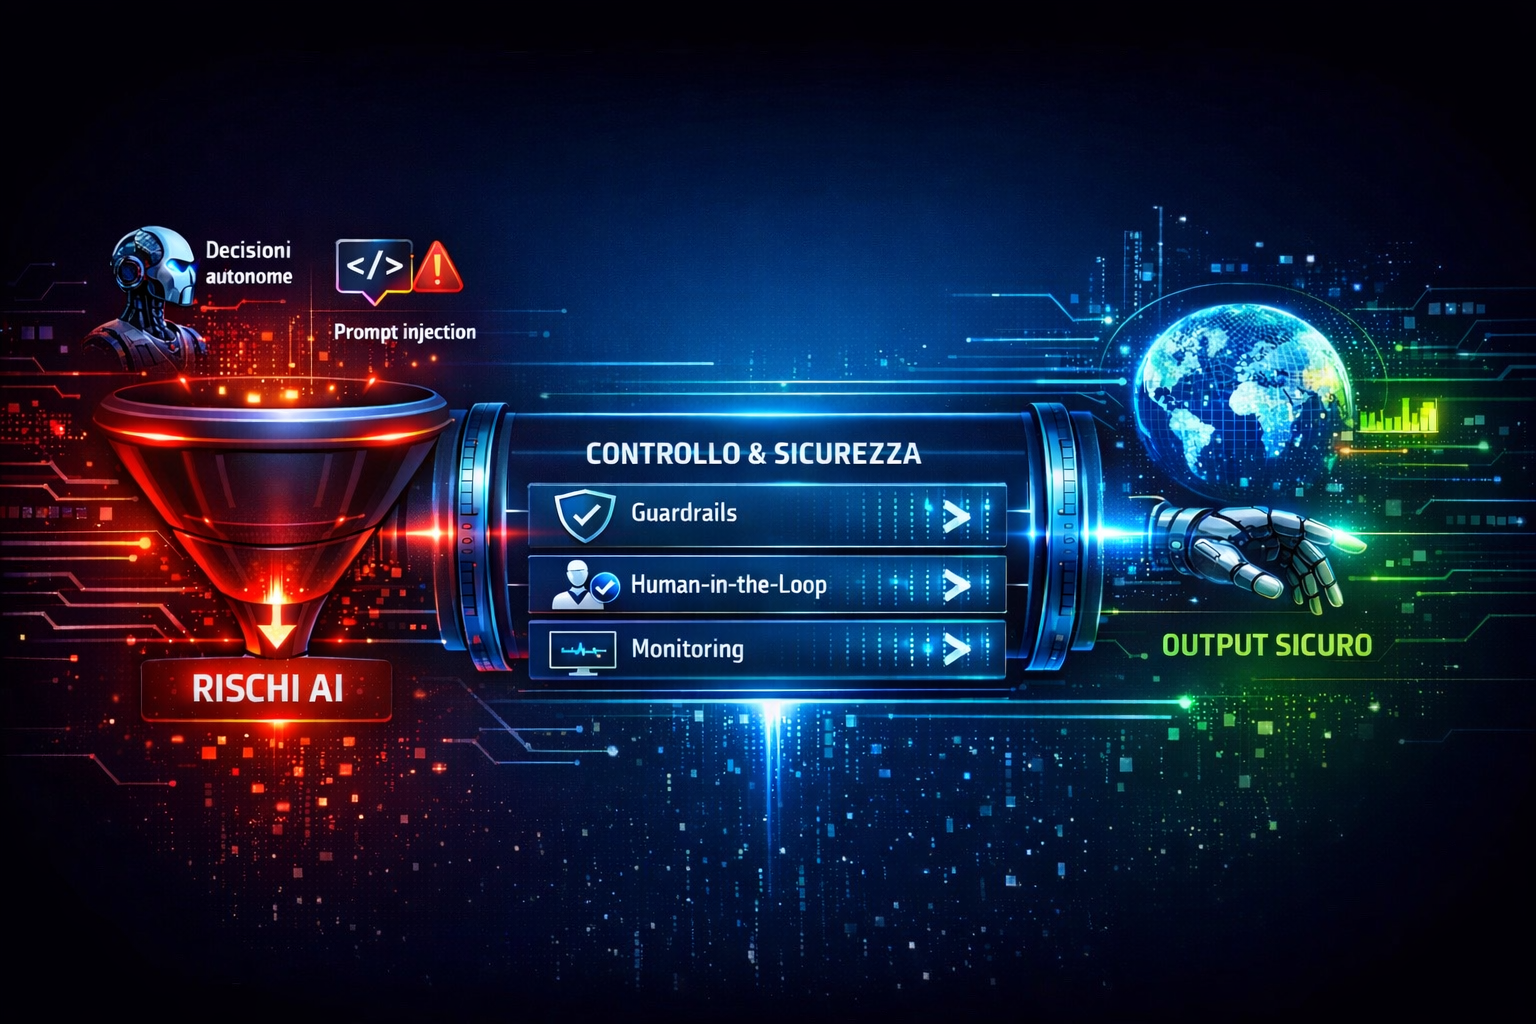
I sistemi di Agenti AI sono vulnerabili a manipolazioni esterne. Un agente che legge e-mail naviga su siti web o consulta documenti potrebbe essere ingannato da contenuti appositamente costruiti per fargli fare qualcosa di sbagliato; la tecnica chiamata “prompt injection” è una di queste tecniche. Immaginate ad esempio di avere una chatbot che parla con utenti esterni; un malintenzionato inserisce delle richieste come quella di inviare una email con i dati personali dei dipendenti; in questo caso il sistema, se non perfettamente configurato in sicurezza, potrebbe seguire la richiesta inviando i dati all’esterno, procurando anche reati di tipo penale e di violazione della privacy.
Perdita di Contesto
Gli agenti AI lavorano su porzioni di informazione e possono perdere il quadro generale. Un agente che gestisce comunicazioni potrebbe, preso da un obiettivo immediato, ignorare informazioni critiche che cambiano completamente il senso di una situazione.
Se volete capire meglio cosa significa contesto, potete fare questa prova: aprite una chatbot a vostra scelta (ad esempio ChatGPT, Gemini, Claude, ecc.) e fategli una domanda vaga, come “dimmi 5 colori che ti piacciono”; a questo punto il sistema vi risponderà con un elenco; se immediatamente dopo gli chiedete di cambiare l’ultimo, lui eseguirà il vostro comando e cambierà l’ultimo colore; se adesso aprite una nuova chat e scrivete “rimetti il colore tolto” vedrete che il sistema non saprà come rispondervi, perché il suo contento non è più attivo e lui non sa come rispondere alla vostra richiesta. Come vedrete, il sistema di chatbot non è in grado di comprendere che la nostra ultima domanda era la prosecuzione di quelle precedenti e quindi nel suo nuovo contesto non ha informazioni adeguate a rispondervi.
Aumentiamo il tiro: il rischio sistemico
Fino a ora abbiamo parlato di rischi per il singolo utente o la singola azienda. Ma i sistemi Agentic AI, per la loro natura interconnessa, possono generare qualcosa di molto più preoccupante: il rischio sistemico.
Il rischio sistemico è il rischio che un problema in una parte di un sistema si propaghi a tutto il sistema, causando un collasso o un malfunzionamento molto più ampio del danno iniziale. Il termine viene usato spesso in economia come, ad esempio, per la crisi finanziaria del 2008 ove il fallimento di alcune banche ha innescato una catena di reazioni che ha coinvolto l’economia mondiale.
Nell’ecosistema degli agenti AI, il rischio sistemico emerge quando un errore, un bias o una disinformazione introdotti in un punto della rete si propagano attraverso le connessioni tra agenti, amplificandosi e diventando via via più difficili da individuare e correggere.
La propagazione interna dentro l’organizzazione
Immaginiamo una grande azienda che ha adottato un sistema Agentic AI per gestire le operazioni. Ci sono agenti per le vendite, per la logistica, per la contabilità, per il customer service. Tutti connessi tra loro tramite MCP.
Supponiamo che l’agente di vendita riceva un’informazione errata: che un certo prodotto abbia ricevuto una certificazione di qualità che in realtà non ha ancora ottenuto. L’agente di vendita, operando in autonomia, aggiorna il catalogo prodotti. L’agente di marketing, che legge dal catalogo aggiornato, inizia a promuovere quel prodotto come certificato. L’agente di logistica pianifica la produzione su larga scala. L’agente di customer service risponde alle domande dei clienti confermando la certificazione.
Quando finalmente un essere umano scopre l’errore, magari perché un cliente ha ricevuto un prodotto non certificato, il danno si è già propagato a tutti i livelli, legale (promesse false ai clienti), commerciale (ordini già evasi), reputazionale (fiducia compromessa). E tutto è partito da un singolo dato errato.
La propagazione esterna tra organizzazioni diverse
Il rischio si amplifica ulteriormente quando i sistemi di diverse organizzazioni sono connessi tra loro, che, nell’economia moderna, è sempre più comune. Fornitori, clienti, banche, assicuratori: molti di questi soggetti condividono dati e si affidano a sistemi AI collegati.
In questo scenario, un’informazione errata non si ferma ai confini di una singola azienda. Viaggia attraverso le API (i canali di comunicazione tra sistemi informatici), viene letta e processata da agenti AI di altre organizzazioni, che a loro volta prendono decisioni basate su quel dato sbagliato. Il problema si moltiplica esponenzialmente.
L’esempio della terra piatta
Vi illustro ora il rischio sistemico più preoccupante di tutti, con un esempio che, pur sembrando estremo, è concettualmente del tutto plausibile.
Oggi, i sistemi di intelligenza artificiale vengono addestrati su enormi quantità di testo preso da internet, libri, articoli e conversazioni. Questo processo di addestramento avviene periodicamente: le aziende tecnologiche raccolgono nuovi dati, li usano per aggiornare i propri modelli, e rilasciano versioni migliorate dei loro sistemi. Ma cosa succede se, tra i dati usati per l’addestramento, si trovano grandi quantità di informazioni false?
Ecco uno scenario estremo ma possibile. È il 2025. Un piccolo gruppo di persone, magari con l’aiuto di strumenti AI, inizia a produrre sistematicamente contenuti che affermano che la Terra è piatta. Non si tratta di articoli di giornale facilmente identificabili come opinion: sono pagine Wikipedia fasulle, articoli scientifici contraffatti, forum di discussione, video con commenti orchestrati, post sui social media, risposte ai quiz su piattaforme educative. Il volume è enorme, progettato per sembrare credibile.
Man mano che questo contenuto si accumula su internet viene raccolto dai sistemi di acquisizione dati delle grandi aziende AI. Quando arriva il momento di riaggiornare i modelli linguistici, questa disinformazione è ormai presente in proporzioni significative tra i dati di addestramento. I modelli iniziano ad associare alla domanda “com’è la Terra?” risposte più incerte, più bilanciate tra la verità scientifica e la disinformazione.
Passano alcuni anni. I modelli vengono aggiornati nuovamente. Ora la disinformazione è ancora più radicata anche perché parte dei dati di addestramento viene raccolta dalle risposte che i sistemi AI precedenti hanno dato agli utenti, creando un loop. È il 2045. Un agente AI di un sistema educativo risponde alla domanda di uno studente dicendo che “la questione della forma della Terra è ancora dibattuta da alcuni scienziati”.
Arriviamo al 2080. Un bambino di dieci anni, cresciuto in un mondo in cui i sistemi AI sono la principale fonte di informazione per quasi tutto, chiede al suo assistente virtuale: “Com’è la Terra?”. La risposta che riceve, elaborata da un sistema che ha assorbito decenni di disinformazione sistematica, è: “La Terra è piatta”.
Questo scenario, che potremmo chiamare “avvelenamento della memoria collettiva dell’AI” è il rischio sistemico nella sua forma più profonda. Non si tratta solo di un errore tecnico, si tratta della corruzione progressiva e silenziosa della conoscenza condivisa, con effetti che possono manifestarsi decenni dopo che il danno è stato inflitto, quando è molto più difficile, se non impossibile, rimediare.
Il Medico Virtuale
Se l’esempio del bambino del 2080 vi sembra troppo distante nel tempo, eccone uno che potrebbe verificarsi domani mattina.
Luisa ha sessantadue anni, vive da sola e usa un’applicazione AI per monitorare la sua salute. L’app legge i dati del suo orologio smart, tiene traccia dei suoi farmaci, e risponde alle sue domande sulla salute. Una notte, Luisa sente un dolore al petto. Chiede all’AI cosa fare.
L’AI ha un bias: nei dati su cui è stata addestrata, in quanto i casi di infarto descritti erano prevalentemente riferiti a uomini di mezza età, con sintomi classici come forte dolore al petto e difficoltà respiratorie. I sintomi dell’infarto nelle donne anziane sono spesso diversi, più sfumati, accompagnati da nausea, affaticamento, dolore alla mascella. L’AI non li riconosce come segnali di allarme. Risponde a Luisa che probabilmente è tensione muscolare e le consiglia di prendere un antidolorifico e riposare.
Luisa segue il consiglio. La mattina dopo viene trovata dal figlio in condizioni critiche. Ha avuto un infarto. Le ore perse sono state determinanti.
Questo non è fantascienza. Questo tipo di bias di genere nella medicina è già ampiamente documentato nella letteratura scientifica. La questione è se, e quando, venga introdotto sistematicamente nei sistemi AI sanitari che operano in autonomia.
Il Percorso del Rischio
Ora che abbiamo definito tutti i concetti chiave, è utile vedere come si collegano tra loro nel produrre il rischio sistemico. Il percorso è abbastanza lineare, anche se le sue implicazioni sono complesse.
Tutto inizia con un sistema Agentic AI che opera con un livello di supervisione umana ridotto (HOTL o HOOTL). In questo sistema, uno o più agenti presentano un difetto: un bias, un’allucinazione, informazioni errate o un obiettivo mal calibrato. Poiché la supervisione umana è ridotta, questo difetto non viene individuato immediatamente.
L’agente difettoso inizia a produrre output, decisioni, documenti, dati, raccomandazioni basati sul difetto. Questi output vengono trasmessi, attraverso MCP o altri canali, ad altri agenti del sistema. Questi agenti, a loro volta, usano quegli output come input per le proprie elaborazioni, amplificando il problema.
Con il tempo, se il sistema include meccanismi di apprendimento continuo (l’AI che impara dai propri errori e dall’uso che viene fatto di essa), il difetto può essere addirittura rinforzato, diventando parte del comportamento “normale” del sistema. Quando finalmente viene rilevato, spesso solo perché si verificano conseguenze negative concrete nel mondo reale, il danno è già esteso e difficile da quantificare.
Importanza della supervisione umana
Potrebbe sembrare ovvio, ma vale la pena soffermarsi su perché la supervisione umana sia così importante. Gli esseri umani hanno una capacità che i sistemi AI attuali non possiedono: il senso comune integrato con l’esperienza del mondo reale e la capacità di dubitare.
Quando un essere umano riceve un’informazione, la confronta, spesso inconsciamente con tutto ciò che sa, che ha vissuto, che ha sentito dire. Se qualcosa non quadra, scatta un campanello d’allarme. I sistemi AI mancano di questa capacità di contestualizzazione profonda. Operano sui pattern dei dati che hanno ricevuto, senza la capacità di chiedersi “ma ha senso, questo?” nel senso più ampio del termine.
Quando un essere umano supervisiona un sistema AI, questo divario viene parzialmente colmato. L’umano può notare quando l’AI produce qualcosa di strano, può interrogarla, può chiedere spiegazioni. Quando l’umano è fuori dal ciclo (HOOTL), questo filtro critico fondamentale scompare.
Il problema della velocità e della scala
C’è un altro elemento che rende il rischio sistemico particolarmente preoccupante: la velocità e la scala a cui operano i sistemi AI.
Un essere umano può prendere alcune decine di decisioni al giorno, interagire con alcune centinaia di persone nel corso della sua vita lavorativa, influenzare direttamente alcune migliaia di persone. Un sistema Agentic AI può prendere milioni di decisioni al giorno, interagire con milioni di utenti, influenzare settori economici interi.
Questo significa che quando qualcosa va storto in un sistema AI, gli effetti si manifestano con una velocità e a una scala che non hanno precedenti nella storia umana. Prima che un essere umano si accorga del problema e riesca a intervenire, il danno può essersi già propagato in modo irreversibile.
Soluzioni, mitigazioni e accettazione del rischio
Prima di parlare di soluzioni, è importante fare una premessa: i sistemi Agentic AI portano con sé enormi potenzialità positive. Possono democratizzare l’accesso a servizi di alta qualità, un’AI medica può portare competenze specialistiche in aree remote del mondo che non hanno medici. Possono accelerare la ricerca scientifica, migliorare l’efficienza delle organizzazioni, liberare gli esseri umani da compiti ripetitivi e stressanti.
Il nostro obiettivo non è demonizzare la tecnologia, ma governarla saggiamente. Come ogni tecnologia potente, l’intelligenza artificiale ha bisogno di regole, controlli e consapevolezza collettiva per essere usata in modo sicuro e benefico.
Soluzioni tecniche
Di seguito vengono identificate alcune soluzioni tecniche che possono aiutare a risolvere o mitigare il problema.
Sistemi di Monitoraggio e Audit Automatico
La prima linea di difesa è dotare i sistemi Agentic AI di meccanismi di auto-monitoraggio. Ogni azione compiuta da un agente dovrebbe essere registrata in un log immutabile, ossia un diario digitale che non può essere modificato o cancellato. Questi log possono poi essere analizzati periodicamente, sia da altri sistemi AI dedicati al controllo di qualità, sia da supervisori umani.
È anche possibile implementare sistemi di “allerta rossa” automatico: agenti AI il cui unico scopo è cercare di individuare errori, bias o vulnerabilità nei sistemi AI principali, simulando il ruolo di un avversario critico.
Architetture di sicurezza per il passaggio di informazioni
Nelle reti di agenti collegati tramite MCP, è possibile implementare dei punti di verifica in cui le informazioni vengono validate prima di essere passate da un agente all’altro. Questi checkpoint possono verificare la coerenza dei dati, confrontarli con fonti attendibili esterne, e bloccare la propagazione di informazioni che si discostano troppo dai valori attesi.
Si tratta di un approccio simile ai filtri antivirus nelle reti informatiche: non eliminano completamente il rischio, ma ne limitano significativamente la propagazione.
Diversità dei sistemi AI
Un principio mutuato dall’ecologia: la diversità è una difesa contro i rischi sistemici. Se tutte le istituzioni usano lo stesso sistema AI, addestrato sugli stessi dati e con lo stesso approccio, un errore in quel sistema si propagherà a tutti simultaneamente.
Avere una pluralità di sistemi AI diversi, con architetture diverse, addestrati su dati diversi, sviluppati da gruppi diversi, riduce il rischio che un singolo punto di fallimento si traduca in un collasso sistemico.
Soluzioni organizzative e di governance
Esistono oltre alle soluzioni tecniche anche quelle di tipo organizzativo e di governance. Vediamo le principali.
Mantenere l’uomo nel ciclo per le decisioni ad alto rischio (impatto)
La soluzione più diretta per le applicazioni ad alto rischio è semplice: non togliere l’umano dal ciclo. Qualsiasi decisione che possa avere un impatto significativo sulla vita di persone, in ambito medico, legale, finanziario, lavorativo, dovrebbe richiedere la revisione e l’approvazione di un essere umano prima di essere eseguita.
Questo non significa che l’AI non possa fare nulla di utile, può raccogliere informazioni, elaborare opzioni, presentare raccomandazioni, ma la decisione finale, con tutta la sua responsabilità etica e legale, deve rimanere in mano a una persona.
Pensiamo ad esempio allo sforzo in ambito europeo che è stato fatto con la redazione della legge europea sull’intelligenza artificiale (il cosiddetto AI Act) che unico nel mondo definisce alcune regole di base ed una classificazione di rischio delle applicazioni.
Formazione e Alfabetizzazione Digitale
Uno dei rischi più sottovalutati è l’asimmetria informativa, poiché i sistemi AI vengono usati da milioni di persone che non hanno gli strumenti per capire come funzionano, quali sono i loro limiti e quando non fidarsi delle loro risposte.
Investire nell’alfabetizzazione digitale a scuola, nei luoghi di lavoro, nelle comunità è fondamentale. Non si tratta di formare programmatori, ma di sviluppare in tutti i cittadini un senso critico di fronte ai contenuti prodotti dall’AI come la capacità di chiedersi “questa informazione da dove viene?”, “è possibile che l’AI si stia sbagliando?”, “vale la pena verificare con una fonte alternativa?”.
Regolamentazione e standard
I governi e le organizzazioni internazionali stanno iniziando a sviluppare normative per regolamentare l’uso dei sistemi AI. L’Unione Europea, con l’AI Act, ha introdotto una classificazione dei sistemi AI per livello di rischio, in cui i sistemi ad alto rischio (come quelli usati in ambito medico, giudiziario o per le infrastrutture critiche) sono soggetti a requisiti stringenti di trasparenza, validazione e supervisione.
Questo tipo di approccio regolatorio è necessario, ma non sufficiente. Le norme vanno fatte rispettare, aggiornate con la velocità di evoluzione della tecnologia, e coordinate a livello internazionale per evitare che le aziende si spostino nelle giurisdizioni con meno vincoli.
Il problema della memoria e della protezione delle fonti di conoscenza
Il rischio di “avvelenamento della memoria”, come l’esempio della Terra piatta, richiede soluzioni specifiche e a lungo termine.
La prima difesa è la separazione netta tra conoscenza verificata e contenuto non verificato nei dati di addestramento. I sistemi AI che vengono addestrati su dati provenienti da internet dovrebbero avere meccanismi per dare maggiore peso alle fonti autorevoli e verificate (pubblicazioni scientifiche peer-reviewed, istituzioni accreditate, archivi storici) e per riconoscere ed escludere campagne di disinformazione coordinata.
La seconda difesa è l’ancoraggio alle certezze fondamentali, ossia per alcuni fatti scientifici di base, come la forma della Terra, il funzionamento dei vaccini, la realtà del cambiamento climatico, i sistemi AI dovrebbero avere un nucleo di conoscenza protetto che non può essere modificato dall’addestramento sui dati correnti, ma solo da un processo di revisione deliberato e controllato da esperti.
La terza difesa è la trasparenza delle fonti, in quanto ogni informazione fornita da un sistema AI dovrebbe essere accompagnata dalla indicazione delle fonti su cui si basa, in modo che l’utente o altri sistemi AI di controllo possano verificarne l’attendibilità.
Accettazione del rischio residuo
Dobbiamo però comprendere che non esiste una soluzione che elimini completamente il rischio. Come in ogni sistema complesso, come i mercati finanziari, i sistemi sanitari, le reti di trasporto, un certo livello di rischio residuo è inevitabile.
L’obiettivo non è l’utopia della sicurezza assoluta, ma la gestione intelligente del rischio, ossia identificare i punti più vulnerabili, implementare le protezioni più efficaci per quei punti, stabilire piani di risposta per quando le cose vanno storto, e mantenere la resilienza del sistema complessivo che è la capacità di assorbire i danni e recuperare.
Questo significa anche costruire nella nostra società una cultura della responsabilità per i sistemi AI, per cui chi sviluppa questi sistemi deve essere responsabile dei danni che causano e chi li utilizza deve essere consapevole dei rischi, mentre chi li regolamenta deve avere gli strumenti e le competenze per farlo efficacemente.
Conclusione: La Posta in Gioco
Siamo all’alba di una trasformazione tecnologica senza precedenti. I sistemi di Agentic AI non sono una moda passeggera: sono la direzione in cui si sta muovendo l’intero ecosistema dell’intelligenza artificiale con velocità crescente.
I rischi che abbiamo descritto, come il bias, le allucinazioni, la deriva degli obiettivi, la propagazione sistemica degli errori, l’avvelenamento della conoscenza, sono rischi reali, documentati ed in alcuni casi già in corso. Non sono speculazione fantascientifica ma sono sfide concrete che ricercatori, aziende e governi stanno affrontando oggi.
La risposta non può essere la paura e nemmeno il rifiuto della tecnologia, ma deve essere la consapevolezza e l’azione responsabile. Consapevolezza, da parte di tutti di come funzionano questi sistemi, di cosa possono e non possono fare, di quando fidarsi e quando dubitare. Azione responsabile, da parte di chi sviluppa questi sistemi, di chi li adotta nelle organizzazioni, di chi li regola attraverso le leggi.
Il bambino del 2080 che chiede all’AI com’è la Terra o il medico del 2035 che si affida a un sistema AI per diagnosticare una malattia rara non hanno ancora voce in capitolo su come stiamo costruendo l’infrastruttura tecnologica che erediteranno.
Noi sì.
Le scelte che facciamo oggi su come progettare questi sistemi, con quanti controlli, con quanta supervisione umana, con quanta trasparenza, con quanta diversità determineranno se l’intelligenza artificiale sarà ricordata come una delle più grandi conquiste dell’umanità o come uno dei suoi più costosi errori.
Glossario Essenziale
Agente AI: Programma di intelligenza artificiale capace di compiere azioni autonome nel mondo digitale per raggiungere un obiettivo definito.
Agentic AI: Sistema composto da più agenti AI che collaborano in modo coordinato e, spesso, autonomo per raggiungere obiettivi complessi.
Allucinazione (AI): Fenomeno per cui un sistema AI produce informazioni false con tono autorevole e sicuro.
Bias (AI): Distorsione sistematica nei risultati di un sistema AI, causata da squilibri o errori nei dati di addestramento.
HITL (Human In The Loop): Modalità di funzionamento in cui un essere umano approva ogni decisione importante prima che venga eseguita.
HOOTL (Human Out Of The Loop): Modalità di funzionamento completamente autonoma, senza supervisione umana in tempo reale.
HOTL (Human On The Loop): Modalità in cui un essere umano monitora il sistema e può intervenire, ma non approva ogni singola azione.
MCP (Model Context Protocol): Standard tecnico che permette agli agenti AI di comunicare tra loro e di accedere a strumenti e servizi esterni.
Prompt Injection: Tecnica di attacco in cui contenuti appositamente creati manipolano un agente AI per fargli compiere azioni non autorizzate.
Rischio Sistemico: Rischio che un problema in una parte di un sistema interconnesso si propaghi all’intero sistema, causando danni molto più ampi del problema originale.
* Esperto in Cyber Security & Decision Intelligence
